

La tabla de características de la muestra: qué estadístico va en cada fila (y qué no debe aparecer) en 2026
La primera tabla de tu capítulo de resultados no contrasta nada: describe quién participó. Y aun así es la que más correcciones recibe, porque casi todos los TFG la construyen a ojo, copiando el formato de otro trabajo sin preguntarse por qué cada fila lleva el estadístico que lleva.
Esta guía la desmonta fila por fila: qué estadístico corresponde a cada tipo de variable, cómo se declaran los datos perdidos, sobre qué denominador van los porcentajes, qué exige la lista de verificación de los estudios observacionales y por qué esa columna de valores p que has visto en tantos artículos probablemente sobra en el tuyo.
Para qué sirve realmente esta tabla
Cumple tres funciones y conviene tenerlas presentes, porque determinan qué entra y qué no:
- Permite juzgar a quién se aplican tus conclusiones. Si tu muestra tiene 22 años de media y el 84 % son mujeres, el lector sabe hasta dónde puede generalizar.
- Documenta la comparabilidad de los grupos, si los tienes. Es el punto de partida de cualquier discusión sobre confusión.
- Deja constancia de las pérdidas. Cuántos casos válidos tienes en cada variable es información metodológica, no un detalle administrativo.
La lista de verificación STROBE, el estándar de referencia para estudios observacionales publicado en 2007, lo formula como su ítem 14, «Descriptive data»: «dar las características de los participantes del estudio (por ejemplo demográficas, clínicas, sociales) e información sobre las exposiciones y los posibles factores de confusión» e «indicar el número de participantes con datos perdidos en cada variable de interés». Su nota al pie añade que la información se dé por separado para cada grupo cuando el diseño los tiene.
Ese ítem 14 es literalmente el guion de tu tabla. El ítem 13, justo antes, cubre el flujo de participantes: cuántos eran elegibles, cuántos entraron, cuántos completaron. Son dos cosas distintas y conviene no mezclarlas.
Qué estadístico va en cada fila
| Tipo de variable | Qué se informa | Ejemplo de celda |
|---|---|---|
| Cuantitativa simétrica | Media y desviación típica | 21,4 (2,8) |
| Cuantitativa asimétrica o con valores extremos | Mediana y rango intercuartílico | 3,0 [1,0-7,0] |
| Cuantitativa con techo o suelo (p. ej. antigüedad, ingresos) | Mediana y RIC, casi siempre | 1 800 [1 200-2 600] |
| Categórica nominal | Frecuencia absoluta y porcentaje | 34 (41,0 %) |
| Categórica dicotómica | Solo una de las dos categorías, con n y % | Mujeres: 68 (81,9 %) |
| Ordinal con pocas categorías | Frecuencia y porcentaje por categoría | Nivel bajo: 12 (14,5 %) |
| Ordinal con muchas categorías (escala tipo Likert sumada) | Mediana y RIC, o media y DT si la escala total se trata como continua | 3,8 (0,6) |
Tres reglas que resuelven la mayoría de las dudas:
- La decisión se toma variable por variable, no de una vez para toda la tabla. Es perfectamente correcto tener una fila con media (DT) y la siguiente con mediana [RIC], siempre que el pie de tabla lo explique.
- No hace falta una prueba de normalidad para decidirlo. Mira el histograma y compara media y mediana: si difieren mucho, la distribución es asimétrica. Las pruebas formales están explicadas en la guía de las pruebas de normalidad, pero para elegir un descriptivo la inspección visual basta y sobra.
- En una variable dicotómica, informa solo una categoría. Poner «Mujeres 81,9 %» y «Hombres 18,1 %» ocupa el doble y no añade nada.
Los porcentajes: el error del denominador
Si tienes 83 participantes y a 7 les falta el dato de nivel de estudios, los porcentajes de esa fila no se calculan sobre 83, sino sobre los 76 casos válidos. Y hay que decirlo.
Las dos formas aceptadas de resolverlo son añadir una columna con el n válido de cada variable, o indicarlo en la nota al pie: «Los porcentajes se calculan sobre los casos válidos de cada variable». Lo que no puedes hacer es calcular sobre el total y que las categorías no sumen 100 % sin explicación, porque el lector no sabrá si hay pérdidas o si te has equivocado.
Este es también el momento de decidir qué hacer con esas ausencias en el análisis posterior; las opciones están comparadas en la guía de datos faltantes: eliminación por lista, por pares o imputación. En la tabla descriptiva, lo único obligatorio es declararlas.
¿Va o no va la columna de valores p?
Depende del diseño, y esta es la parte que más discusiones genera con los tutores:
- Estudio observacional con grupos preexistentes (por ejemplo, comparar dos titulaciones o dos centros): tiene sentido contrastar las características, porque las diferencias entre los grupos son un hallazgo real y condicionan la interpretación. Aun así, es más informativo reportar la magnitud de la diferencia —una diferencia media estandarizada— que un valor p.
- Ensayo con asignación aleatoria: no. Si los grupos se formaron al azar, cualquier diferencia basal es por definición azar, y contrastarla no informa de nada. Un valor p pequeño en una tabla basal aleatorizada solo indica que la aleatorización produjo, en esa variable, la diferencia que cabía esperar en uno de cada veinte casos. El estándar de referencia para ensayos, actualizado en 2025 con la declaración CONSORT 2025 (BMJ 2025;388:e081123), pide la tabla basal por grupos, no su contraste estadístico.
- Muestra única sin grupos: no hay nada que contrastar. La tabla es puramente descriptiva.
Si tu diseño es cuasi-experimental y las diferencias basales te preocupan de verdad, la solución no es una columna de p, sino un método que las neutralice: el emparejamiento por puntaje de propensión o el ajuste por covariables con un ANCOVA.
El formato APA de la tabla
La estructura mínima es esta:
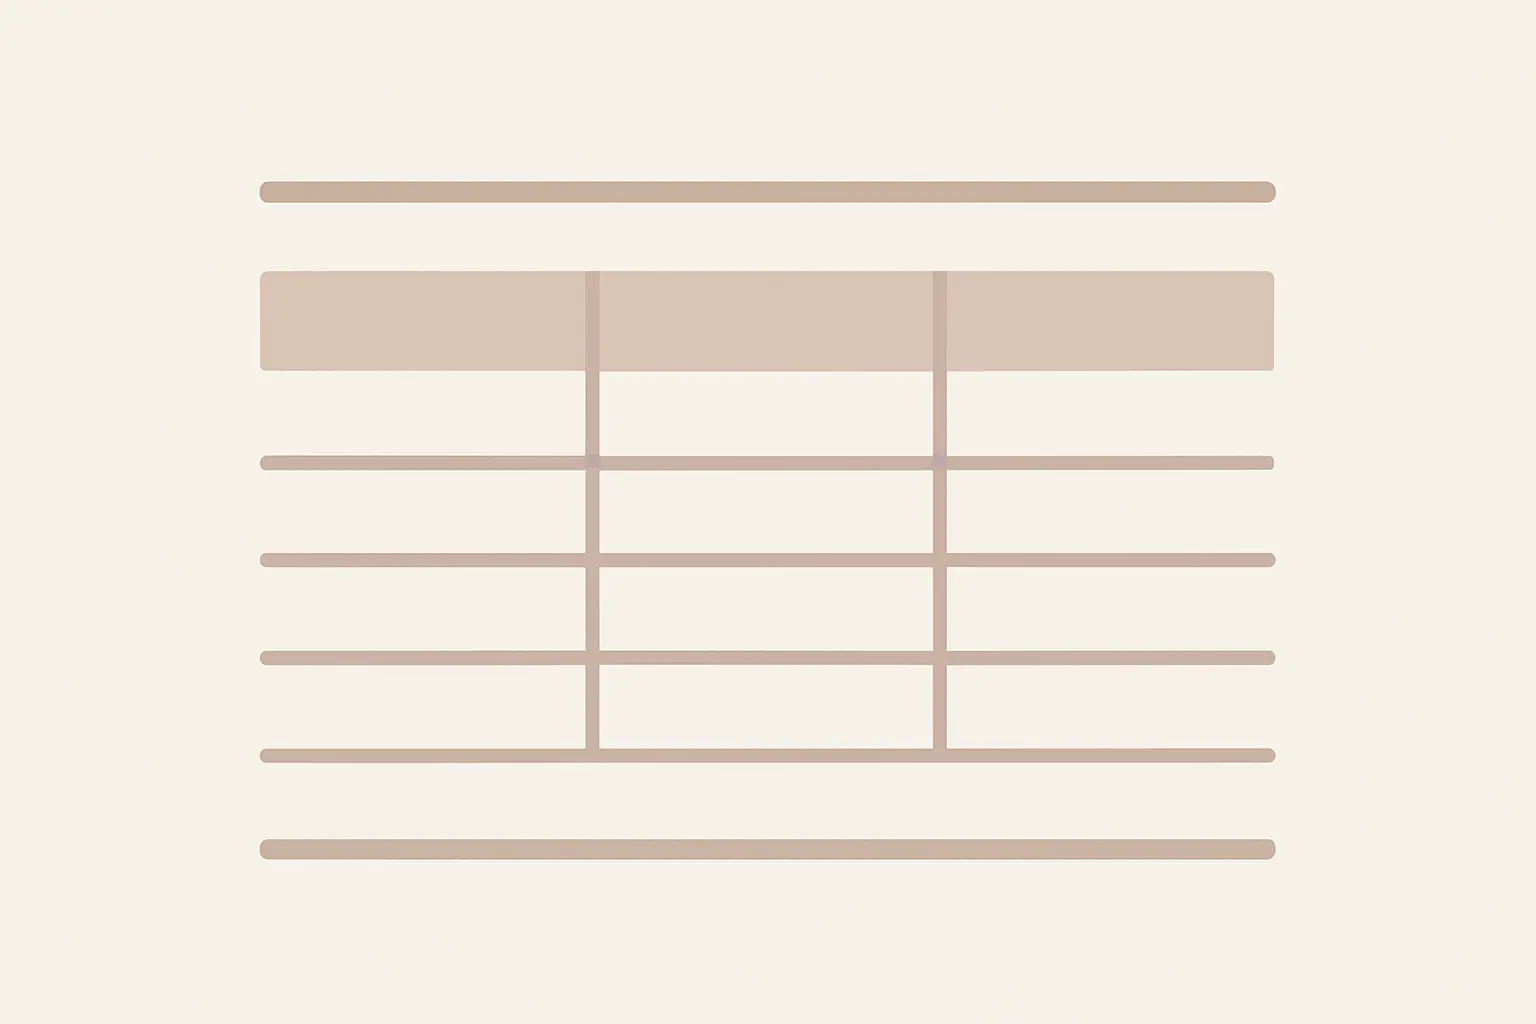
- Número de tabla en negrita, en su propia línea: Tabla 1.
- Título en cursiva, en la línea siguiente, breve y descriptivo: Características sociodemográficas de la muestra. Sin punto final.
- Encabezados de columna con el n de cada grupo: «Grupo experimental (n = 42)».
- Cuerpo sin líneas verticales y con solo tres horizontales: arriba, bajo los encabezados y al final.
- Nota debajo, empezando por «Nota.» en cursiva, con las abreviaturas, el criterio de los porcentajes y el estadístico usado en cada fila.
Sobre las cifras concretas —cuántos decimales, coma o punto, qué símbolos van en cursiva— la referencia está en la guía de coma decimal, cursivas y cifras en APA 7 en español. Y para montarla materialmente en el procesador de textos, la de insertar y numerar tablas y figuras en Word.
Ejemplo completo
| Variable | Total (N = 83) | Grupo A (n = 42) | Grupo B (n = 41) |
|---|---|---|---|
| Edad en años, M (DT) | 21,4 (2,8) | 21,1 (2,6) | 21,8 (3,0) |
| Mujeres, n (%) | 68 (81,9) | 35 (83,3) | 33 (80,5) |
| Curso, n (%) | |||
| Tercero | 39 (47,0) | 21 (50,0) | 18 (43,9) |
| Cuarto | 44 (53,0) | 21 (50,0) | 23 (56,1) |
| Horas de estudio semanales, Mdn [RIC] | 10 [6-15] | 11 [7-16] | 9 [6-14] |
| Trabaja durante el curso, n (%)a | 29 (37,2) | 14 (35,0) | 15 (39,5) |
Nota. M = media; DT = desviación típica; Mdn = mediana; RIC = rango intercuartílico. Los porcentajes se calculan sobre los casos válidos de cada variable. a 5 valores perdidos.
Fíjate en tres detalles: las categorías de una variable nominal van sangradas bajo su etiqueta, las horas de estudio llevan mediana porque la distribución es asimétrica, y la última fila declara sus perdidos con una llamada. Nada de eso ocupa espacio extra y todo se lee de un vistazo.
El párrafo que acompaña a la tabla
Una tabla nunca va sola. El texto no repite los números: los interpreta y destaca los dos o tres que importan.
La muestra final estuvo compuesta por 83 estudiantes (véase la Tabla 1), con una edad media de 21,4 años (DT = 2,8) y una amplia mayoría de mujeres (81,9 %), proporción coherente con la distribución por sexo de la titulación. La mediana de horas de estudio semanales fue de 10 [RIC 6-15], con una distribución claramente asimétrica. Los dos grupos resultaron similares en todas las variables recogidas.
Recuerda que la llamada a la tabla va en presente aunque el resto de los resultados esté en pasado; ese matiz y todos los demás están en la guía de tiempo verbal por capítulo.
Errores que penalizan
- Media y desviación típica en una variable claramente asimétrica. Los ingresos, las horas trabajadas, los tiempos de espera y los recuentos casi nunca son simétricos.
- Porcentajes con un decimal en una muestra de 30 personas. Con n = 30, cada caso vale 3,3 puntos: los decimales fingen una precisión que no existe.
- Meter en la tabla la variable de resultado. La tabla descriptiva describe a los participantes; el resultado va después, en su propio apartado.
- Poner el rango en lugar del rango intercuartílico. El rango (mínimo-máximo) lo determinan dos personas; el RIC describe al 50 % central. No son intercambiables.
- Repetir en el texto todos los números de la tabla. Se destacan dos o tres; el resto está en la tabla precisamente para no escribirlo.
- Olvidar el N total en el encabezado. El lector debe poder reconstruir cualquier porcentaje.
Preguntas frecuentes
¿Cuántas variables debe tener la tabla?
Las necesarias para caracterizar a la muestra y las que puedan actuar como variables confusoras según tu marco teórico. En un TFG, entre seis y doce filas es lo habitual. Una tabla de treinta filas indica que estás volcando el cuestionario entero.
¿Puedo poner el intervalo de confianza en la tabla descriptiva?
No es lo habitual. El intervalo de confianza estima un parámetro poblacional y encaja en las tablas de resultados inferenciales; en la descriptiva basta con la dispersión de tu muestra.
¿Y si mi muestra no tiene grupos?
Entonces la tabla tiene una sola columna de datos. Sigue siendo obligatoria: sin ella, el lector no sabe a quién se refieren tus resultados.
¿Dónde va el diagrama de flujo de participantes?
Antes de la tabla, o sustituyendo al párrafo de reclutamiento. Cubre el ítem 13 de STROBE —elegibles, incluidos, analizados— y es distinto de la tabla descriptiva. Si tu trabajo es una revisión, el diagrama que necesitas es otro, el de la guía del diagrama de flujo PRISMA.
¿Qué lista de verificación debo adjuntar?
Depende del diseño. STROBE para estudios observacionales, CONSORT para ensayos aleatorizados —en su versión 2025—, y otras para diseños específicos; el mapa completo está en la guía de qué checklist adjuntar a tu TFG.
¿SPSS genera esta tabla automáticamente?
Genera los descriptivos, no la tabla. Tendrás que ejecutar Frecuencias para las categóricas y Descriptivos o Explorar para las cuantitativas, y montar la tabla a mano. El procedimiento está en la guía de elaboración de tablas de datos con SPSS.
¿Se numera como Tabla 1 aunque tenga tablas en el marco teórico?
La numeración es correlativa en todo el documento, así que si ya has usado dos tablas antes, esta será la Tabla 3. La convención de llamarla «Tabla 1» viene de los artículos científicos, donde suele ser efectivamente la primera.
¿Y si algunos participantes abandonaron a mitad del estudio?
Describe la muestra que efectivamente analizaste y declara los abandonos con su número y, si los conoces, sus motivos. Comparar a quienes abandonaron con quienes continuaron es un análisis breve que suma mucho a la sección de limitaciones.
De la tabla al capítulo redactado
Montar la tabla es media hora. Escribir el capítulo de resultados completo —el párrafo que la acompaña, los contrastes, la nota al pie, la coherencia con la metodología— es lo que consume las tardes. Tesify parte de tus propios datos: no inventa cifras, te ayuda a estructurar y redactar cada apartado a partir de lo que tú has obtenido, con el formato y las referencias resueltos.
Empieza gratis con Tesify y termina tu capítulo de resultados. Más de 9.000 estudiantes ya lo usan, y el 100 % del texto sigue siendo tuyo.
Escribe tu TFG o tesis con IA
Pasa de la teoría a tu documento terminado
Tesify estructura, redacta y formatea tu TFG, TFM o tesis en normas APA y Vancouver, con bibliografía automática y verificación antiplagio integrada. Regístrate gratis, sin tarjeta.
Deja una respuesta