
Series temporales IA en tu TFG: ARIMA, Prophet y LSTM con ejemplos (2026)
El análisis de series temporales permite estudiar cómo evolucionan las variables a lo largo del tiempo, y el enfoque de series temporales IA, que combina modelos estadísticos clásicos con aprendizaje automático, se ha vuelto habitual en TFG de economía, finanzas, epidemiología, ciencias ambientales y marketing. Si tus datos tienen una dimensión temporal y quieres identificar tendencias, estacionalidad o hacer predicciones, esta guía te explica qué modelo elegir, cómo validarlo y cómo redactarlo en tu metodología.
¿Qué es una serie temporal?
Una serie temporal es un conjunto de observaciones de una variable cuantitativa registradas en instantes sucesivos de tiempo, normalmente a intervalos regulares. La clave es el orden: cada observación está asociada a un momento específico y ese orden importa para el análisis. Si desordenas los datos, pierdes precisamente la información que quieres estudiar: la dependencia entre lo que ocurre hoy y lo que ocurrió antes.
Ejemplos habituales en TFG: precio mensual del petróleo durante diez años, número de contagios diarios durante una epidemia, ventas trimestrales de una empresa, temperatura media anual en una región o demanda horaria de electricidad. En todos ellos el objetivo puede ser descriptivo (entender la evolución), explicativo (relacionar la serie con otras variables) o predictivo (estimar valores futuros).
Antes de elegir un modelo conviene delimitar bien qué pregunta quieres responder. Si todavía no lo tienes claro, revisa cómo identificar y redactar el vacío de investigación: aunque el ejemplo es de Psicología, la lógica para justificar por qué tu predicción aporta algo nuevo es la misma.
Componentes de una serie temporal
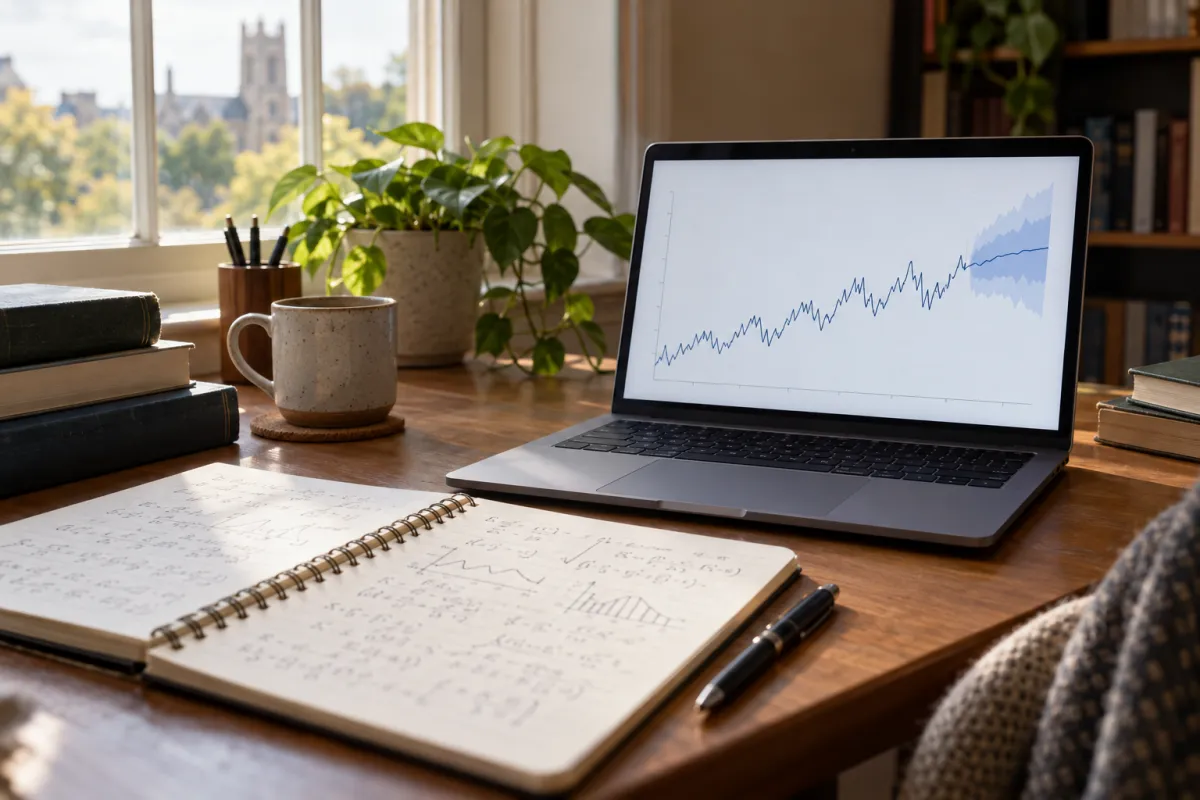
Toda serie temporal puede descomponerse en cuatro componentes:
- Tendencia (T): movimiento a largo plazo de la serie, ascendente, descendente o estable.
- Estacionalidad (S): fluctuaciones periódicas que se repiten con un patrón regular (anual, mensual, semanal).
- Ciclo (C): oscilaciones de duración variable relacionadas con ciclos económicos u otros factores de largo alcance.
- Componente irregular o residual (I): variaciones aleatorias no explicadas por los otros componentes.
La descomposición de la serie es el primer paso del análisis. En Python, statsmodels.tsa.seasonal.seasonal_decompose() separa tendencia, estacionalidad y residuo; la función STL de la misma librería ofrece una descomposición más robusta frente a valores atípicos. Debes decidir además si la descomposición es aditiva (la estacionalidad tiene amplitud constante) o multiplicativa (la amplitud crece con el nivel de la serie, algo frecuente en ventas o turismo).
Otro concepto imprescindible es la estacionariedad: una serie es estacionaria cuando su media, su varianza y su estructura de autocorrelación no cambian con el tiempo. Muchos modelos clásicos la exigen. Para comprobarla se usan contrastes como Dickey-Fuller aumentado (ADF), cuya hipótesis nula es la presencia de raíz unitaria, y KPSS, cuya hipótesis nula es la estacionariedad. Usarlos de forma conjunta y comentar ambos resultados da solidez a tu apartado metodológico.
Modelos clásicos más usados en TFG
ARIMA (Autoregressive Integrated Moving Average)
Es el modelo de referencia para series univariadas, popularizado por la metodología de Box y Jenkins. Se define por tres parámetros: p (orden autorregresivo), d (número de diferenciaciones necesarias para lograr estacionariedad) y q (orden de medias móviles). La selección de parámetros se apoya en los gráficos ACF y PACF o en criterios de información como AIC y BIC; en Python, pmdarima.auto_arima() automatiza la búsqueda, pero en el TFG debes explicar por qué aceptas el modelo propuesto.
SARIMA (ARIMA estacional)
Extensión de ARIMA para series con estacionalidad. Añade parámetros estacionales P, D, Q y el periodo estacional m (12 en datos mensuales, 4 en trimestrales). Es adecuado cuando el patrón estacional es claro y estable. Si incorporas variables explicativas externas (por ejemplo, festivos o precio de un competidor), hablarás de SARIMAX.
Suavizado exponencial (ETS y Holt-Winters)
Los métodos de suavizado exponencial ponderan más las observaciones recientes. El método de Holt incorpora tendencia y el de Holt-Winters añade estacionalidad. Son fáciles de interpretar y a menudo resultan competitivos frente a modelos más complejos, por lo que funcionan muy bien como modelo de comparación en un TFG.
Regresión con variable tiempo
La opción más sencilla: incluir el tiempo como variable independiente en una regresión lineal. Es adecuada cuando solo quieres modelar la tendencia y no la dinámica temporal completa, por ejemplo en TFG con análisis descriptivos. Si tu variable dependiente es binaria, conviene repasar otros enfoques, como la regresión logística y la interpretación del odds ratio.
Modelos de IA para series temporales
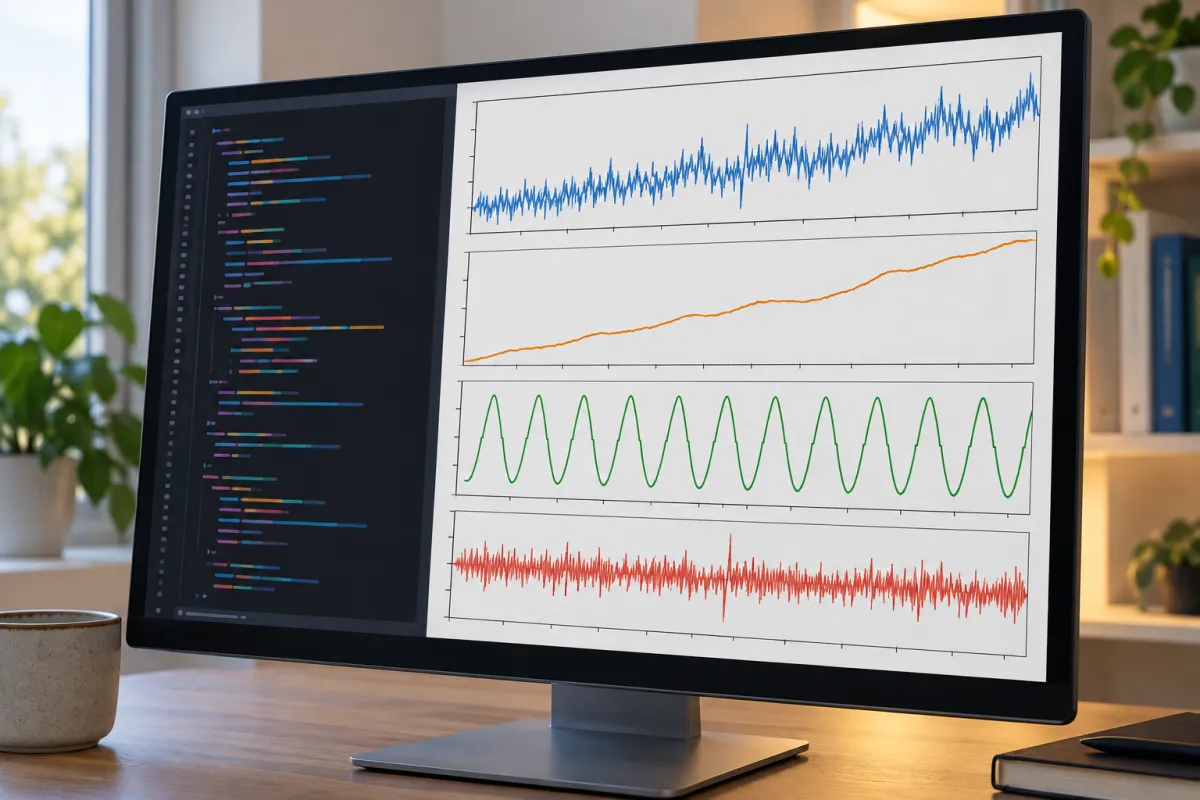
La inteligencia artificial aporta modelos capaces de capturar relaciones no lineales y de combinar muchas variables. No sustituyen a los métodos clásicos: lo recomendable en un TFG es compararlos con ellos y justificar si la mejora compensa la pérdida de interpretabilidad.
Prophet
Desarrollado por el equipo de ciencia de datos de Meta (entonces Facebook) y descrito por Taylor y Letham en el artículo «Forecasting at scale», Prophet es un modelo aditivo que descompone la serie en tendencia, estacionalidades múltiples y efecto de festivos. Es tolerante a datos faltantes y cambios de tendencia, y su sintaxis es sencilla. Su limitación es que no modela explícitamente la autocorrelación de los residuos, así que debes revisarlos igual que en cualquier otro modelo.
Redes LSTM
Las redes Long Short-Term Memory, propuestas por Hochreiter y Schmidhuber en 1997, son redes neuronales recurrentes diseñadas para recordar dependencias a largo plazo. Se implementan con Keras o PyTorch y requieren transformar la serie en ventanas de entrada y salida, normalizar los datos y ajustar hiperparámetros (número de capas, unidades, tasa de aprendizaje, épocas). Suelen necesitar series largas y su entrenamiento es sensible a la semilla aleatoria, por lo que conviene repetir el entrenamiento varias veces e informar de la variabilidad.
Modelos de árboles con variables de retardo
Algoritmos como Random Forest, XGBoost o LightGBM pueden predecir series si construyes variables de retardo (el valor de hace 1, 7 o 12 periodos), medias móviles y variables de calendario. Son una alternativa intermedia: más flexibles que ARIMA y más fáciles de entrenar que una LSTM.
Cómo elegir entre modelos clásicos y de IA
- Serie corta y univariada: ARIMA, SARIMA o ETS suelen ser suficientes.
- Varias estacionalidades o festivos: Prophet o SARIMAX con variables de calendario.
- Serie larga con muchas variables explicativas: modelos de árboles o LSTM.
- Objetivo explicativo: prioriza modelos interpretables; la IA encaja mejor cuando el objetivo es predictivo.
Validación, métricas y diagnóstico de residuos
El error más frecuente en TFG es validar como si los datos fueran independientes. En series temporales nunca debes mezclar aleatoriamente los datos: el conjunto de entrenamiento debe ser siempre anterior al de prueba. Lo habitual es reservar el último tramo de la serie como test o aplicar validación cruzada con origen móvil (rolling origin), disponible en scikit-learn con TimeSeriesSplit.
Para medir el error se usan:
- MAE: error absoluto medio, fácil de interpretar en las unidades de la serie.
- RMSE: penaliza más los errores grandes.
- MAPE: error porcentual; no es adecuado si la serie toma valores cercanos a cero.
- MASE: compara el error con el de un modelo ingenuo, útil para comparar series distintas.
Incluye siempre un modelo de referencia (por ejemplo, el ingenuo estacional, que predice el valor del mismo periodo del año anterior). Si tu LSTM no mejora a este modelo, es un resultado válido que debes discutir, no ocultar.
En cuanto al diagnóstico, los residuos de un buen modelo deberían comportarse como ruido blanco. Revisa el gráfico ACF de los residuos y aplica el contraste de Ljung-Box; si detectas autocorrelación, el modelo no ha capturado toda la estructura. Comprueba también la normalidad y la homocedasticidad, especialmente si vas a construir intervalos de predicción.
Herramientas para el análisis
| Herramienta | Ventaja para TFG | Curva de aprendizaje |
|---|---|---|
| Python (statsmodels, Prophet, Keras) | Más flexible, código reproducible, cubre modelos clásicos y de IA | Media |
| R (forecast, fable, tseries) | Más tradicional en estadística académica | Media-alta |
| Excel + Análisis de datos | Sin programación, suficiente para modelos simples | Baja |
Como referencia bibliográfica práctica, el manual Forecasting: Principles and Practice de Hyndman y Athanasopoulos está disponible en abierto y explica con ejemplos en R la mayoría de los modelos citados.
Fuentes de datos para series temporales en España
- INE (Instituto Nacional de Estadística): series macroeconómicas, demografía, IPC, paro. Acceso gratuito con API.
- Banco de España: series financieras, tipos de interés, crédito. Descarga directa en CSV.
- EUROSTAT: datos europeos comparados. Útil para TFG con componente comparativo.
- FRED (Federal Reserve Economic Data): series económicas internacionales, acceso gratuito.
- Yahoo Finance: precios de acciones e índices bursátiles, descargables con Python (
yfinance).
Si tu trabajo es del ámbito social, en esta guía sobre dónde encontrar datos abiertos en el INE y en observatorios encontrarás más fuentes con series largas. Y si analizas la evolución de la eficiencia de empresas o unidades públicas, puedes complementar la serie con un Análisis Envolvente de Datos (DEA) aplicado a varios periodos.
Cómo redactar la metodología en el TFG
El tribunal valora que el apartado metodológico permita replicar el análisis. Una estructura recomendable es:
- Datos: fuente, periodo, frecuencia, número de observaciones y tratamiento de valores faltantes o atípicos.
- Análisis exploratorio: gráfico de la serie, descomposición y contrastes de estacionariedad.
- Modelos candidatos: modelo de referencia, modelo clásico y modelo de IA, con la justificación de cada uno.
- Estrategia de validación: partición temporal, horizonte de predicción y métricas.
- Diagnóstico: pruebas sobre los residuos y limitaciones detectadas.
- Software: lenguaje, librerías y versiones, con un repositorio de código si tu universidad lo permite.
Cita las fuentes de datos y las librerías según el estilo que exija tu facultad, habitualmente APA 7. Para organizar el borrador de la metodología y los resultados puedes apoyarte en Tesify — Escribe tu TFG y Tesis con IA, y generar las referencias de Box y Jenkins, Hyndman o Taylor y Letham con Tesify Bibliografía Automática. Revisa siempre el resultado: la responsabilidad académica del texto final es tuya.
Preguntas frecuentes
¿Cuántos datos necesito para un análisis de series temporales en mi TFG?
Para modelos ARIMA básicos se recomienda un mínimo orientativo de 50 observaciones. Para modelos estacionales necesitas varios ciclos completos, al menos tres o cuatro. Con datos mensuales, cuatro o cinco años suelen ser suficientes; con datos anuales, necesitarás décadas de historia. Los modelos LSTM requieren series bastante más largas.
¿Qué diferencia hay entre análisis de series temporales y regresión lineal?
La regresión lineal asume que las observaciones son independientes entre sí. En series temporales las observaciones están correlacionadas en el tiempo. Si aplicas regresión lineal a datos temporales sin tener en cuenta esta dependencia, los errores estándar serán incorrectos y las inferencias, inválidas. Los modelos ARIMA incorporan explícitamente esa dependencia temporal.
¿Es mejor usar IA o ARIMA en un TFG de series temporales?
Depende del objetivo y de los datos. Con series cortas y univariadas, ARIMA o el suavizado exponencial suelen ser suficientes e interpretables. Los modelos de IA como LSTM o XGBoost aportan valor con series largas y muchas variables. Lo más sólido es comparar ambos frente a un modelo de referencia.
¿Cómo compruebo si mi serie es estacionaria?
Combina la inspección visual de la serie y de su ACF con contrastes formales: Dickey-Fuller aumentado, cuya hipótesis nula es la raíz unitaria, y KPSS, cuya hipótesis nula es la estacionariedad. Si la serie no es estacionaria, aplica diferenciaciones o transformaciones logarítmicas.
¿Qué métricas debo usar para evaluar la predicción?
Las más habituales son MAE, RMSE y MAPE, calculadas sobre un conjunto de prueba posterior al de entrenamiento. MASE es útil para comparar con un modelo ingenuo. Evita MAPE si la serie tiene valores cercanos a cero.
¿Puedo hacer validación cruzada con series temporales?
Sí, pero no con particiones aleatorias. Se usa la validación con origen móvil, en la que cada bloque de prueba es posterior a su bloque de entrenamiento. En Python se implementa con TimeSeriesSplit de scikit-learn.
¿Qué debo incluir en la metodología de un TFG con series temporales?
Describe la fuente y frecuencia de los datos, el análisis exploratorio, los modelos candidatos y su justificación, la estrategia de validación, las métricas, el diagnóstico de residuos y el software empleado con sus versiones, de forma que el análisis pueda replicarse.
Escribe tu TFG o tesis con IA
Pasa de la teoría a tu documento terminado
Tesify estructura, redacta y formatea tu TFG, TFM o tesis en normas APA y Vancouver, con bibliografía automática y verificación antiplagio integrada. Regístrate gratis, sin tarjeta.
Deja una respuesta